「健康系の本を50冊、PDFにしてDifyに全部入れたいんですが、できますか?」
問い合わせはこういう始まり方でした。LINE連携のチャットボットを複数作りたい、ソースは書籍を大量にスキャンしたもの。Difyに大量のPDFを入れ込めるのかよくわからない、という相談です。
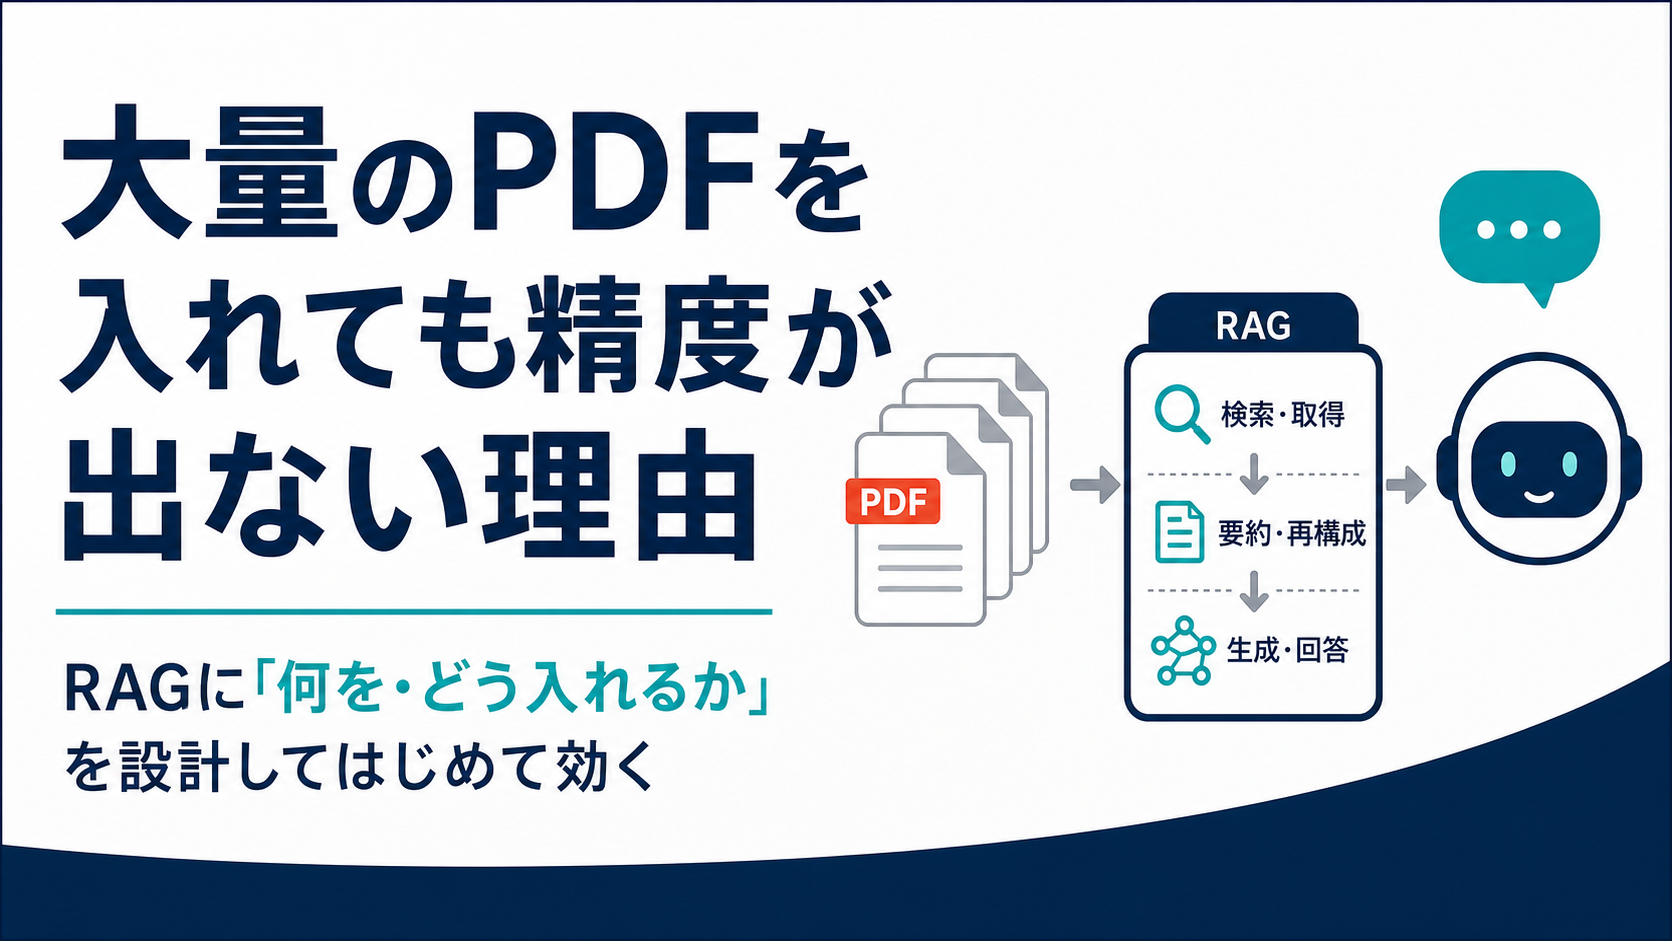
「入れること自体はできます」と答えるのは簡単です。ただ、そのまま放り込んだだけでは精度が出ない、というのが実際のところで、そこを一緒に設計する必要があります。
何が起きるか
PDFをそのままナレッジに登録しても、回答が的外れになるパターンは大体決まっています。
スキャンしたPDFは、まずOCR(文字認識)が通らないと文字として取り出せません。画像として保存されているページは自動ではテキストにならない。ここで引っかかって「読めているつもりで読めていない」状態になります。
文字が取り出せたとしても、今度は検索の問題が出ます。AIがナレッジから回答を作るとき、文書全体を毎回読み直しているわけではなく、質問に関連しそうな部分だけを拾ってきて使います。この拾い方が、文書の切り方に大きく左右されます。
500ページの本を1ファイルとして登録すると、拾われる塊が大きくなりすぎて検索精度が落ちます。逆に1文ずつ細かく切りすぎると、文脈が失われて答えにならない断片だけが返ってくる。大きすぎず小さすぎず、この塩梅を決めるのが実は一番効く作業です。
50冊を入れるなら、まず整理から
このケースでまず勧めたのは、50冊を一気に1つのアプリに突っ込む前に整理する作業です。
カテゴリを分ける。健康系といっても、食事・運動・メンタル・特定疾患ではカバー範囲が全然違います。同じ塊に混ぜて入れると、「食事について聞いたのにメンタルの話が返ってきた」という現象が起きやすくなります。テーマごとにナレッジを分けるか、アプリ自体を分けるかを先に決めます。
分割サイズを決める。ざっくり言うと「数段落ごとに区切る」くらいのイメージです。1段落だと短すぎ、1章まとめてだと長すぎ。500トークン前後が目安と言われていますが、書籍の構成によって変わります。章立てがはっきりしている本は章単位で切ると整合性が保ちやすい。
メタデータをつける。「これは第3章の食事制限に関する節」「対象は糖尿病の方向け」のような情報を付けておくと、検索の精度が上がります。ファイルをただ放り込むだけでは、この情報が失われます。
検索の精度が変わる設定
Difyには、登録したナレッジをどう「拾ってくるか」の設定があります。
セマンティック検索は、言葉の意味で探します。「スマートフォン利用のルール」を聞いたとき、「モバイル端末ポリシー」という表現の文書も引っかかる。キーワードで一致しなくても意味が近ければ返ってくる設計です。
キーワード検索との組み合わせも選べます。意味での検索と言葉での検索を両方かける「ハイブリッド」が、多くのケースで安定します。どちらか片方だけだと、漏れるパターンが出やすい。
インデックスの品質設定もあります。高品質モードにするとコストが上がりますが、検索精度は上がります。50冊を投入するなら、まず試験的にカテゴリ1つ分だけ高品質モードで試して、回答の質を確認してから全量に展開する流れが現実的です。
入れたら終わりではない
RAGは入れたら完成ではなく、入れたらテストの始まりです。
想定される質問を20〜30問用意して、実際に聞いてみます。返ってきた回答が的外れなら、原因を切り分けます。ナレッジに情報がそもそも入っていないのか、入っているのに検索で拾えていないのか、拾えているのにAIが上手く使えていないのか。原因によって対処が変わります。
拾えていないなら分割サイズかインデックス設定の見直し。使えていないならプロンプト(AIへの指示)の調整。情報が不足しているならナレッジの追加。
50冊を放り込んで、あとはAIが賢くしてくれるとはならない、というのが正直なところです。どの質問に答えさせたいか、どんな文書でそれをカバーしているか。この設計を先に決めてから投入する順番が、結果的に早い。
「入れられますか?」より先に聞くこと
最初の問い合わせに戻ると、「Difyに大量のPDFを入れられますか?」という質問の前に確認しておきたいことがあります。
スキャンPDFか、テキストPDFか。表や図が多い書籍か。回答させたい質問の種類は何か。複数テーマを1つのボットで扱うか、分けるか。
この整理なしに全部入れてチャットボット完成を目指すと、後から直す箇所が多くなります。最初の設計に少し時間をかける方が、結局ラクです。