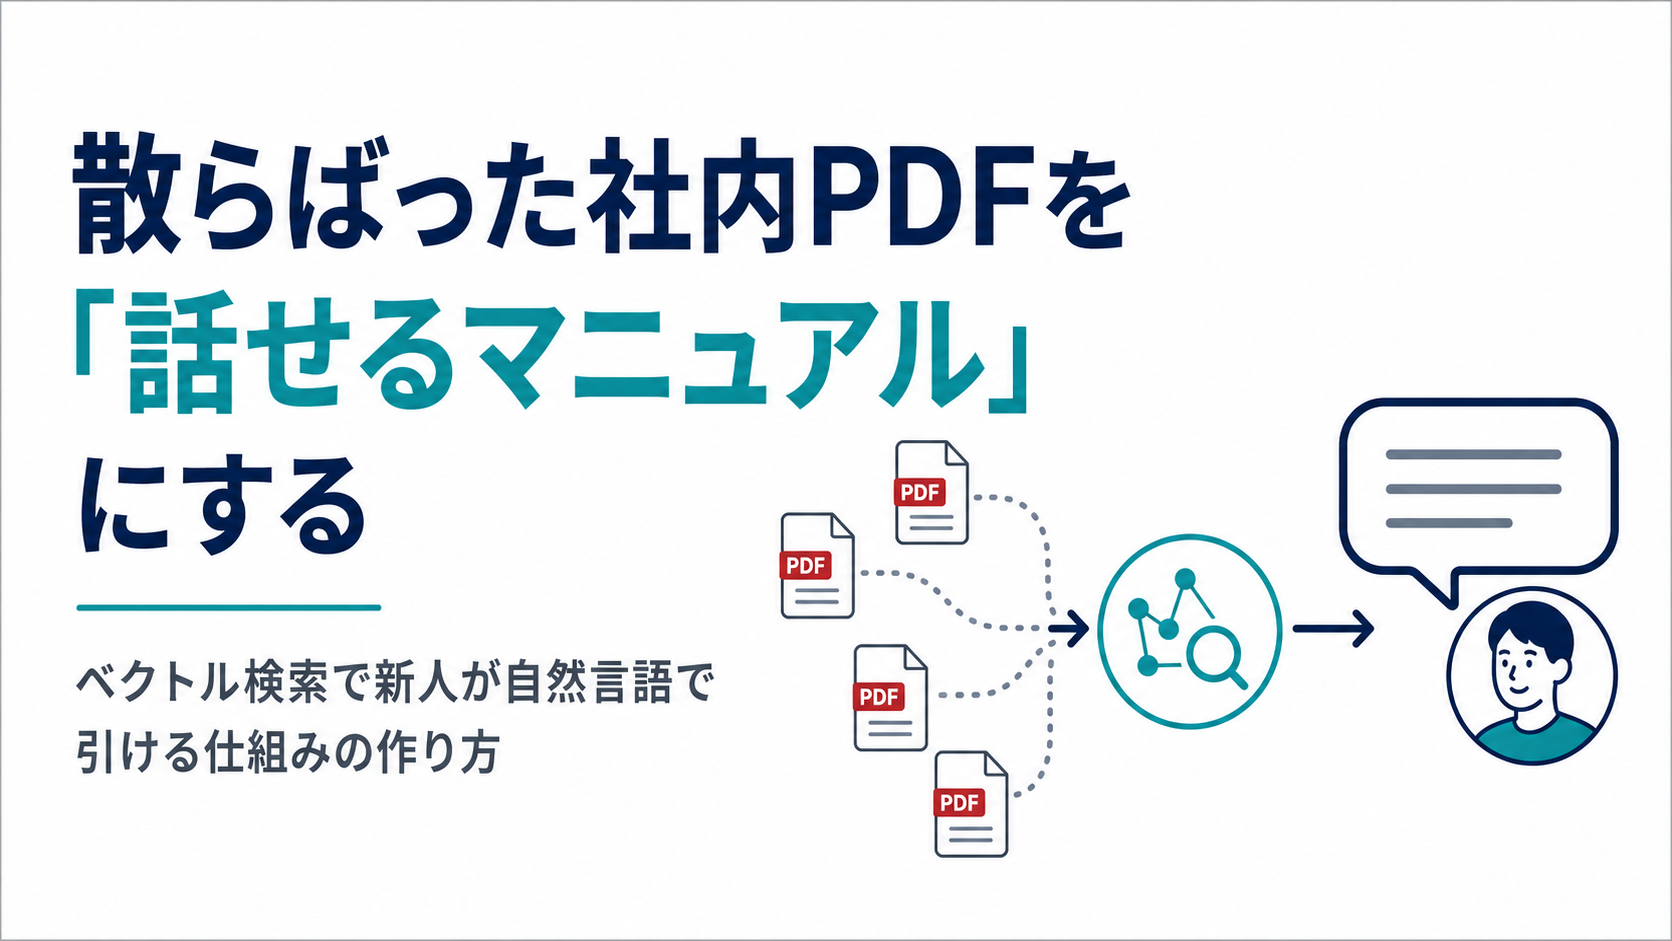
新人が「この手順、どこに書いてありましたっけ」と聞くたびに、誰かが答えている。探すのが面倒で、毎回同じ人に聞く。
そういう状況を何度か見てきました。ファイルサーバーにはPDFが何十本と入っているのに、フォルダ名が分かりにくくて辿り着けない。日付別に整理されていて、どのバージョンが最新か分からない。結局、先輩に聞くのが一番早い。
これ、仕組みで解決できます。
整形不要、という事実
最初に相談を受けたとき、向こうも私も「PDFをAIに学習させる形式に変換しないといけないはず」と思っていました。
実際にやり方を確認してみると、そんな必要はありませんでした。既存のWord、PDF、テキストファイルをそのまま取り込める。整形ゼロです。
顧客からよく来る最初の質問が「データはどんな形式で渡せばいいですか」です。この質問に対する答えが「今ある形式のまま入れてください」だと伝えると、だいたい拍子抜けされます。構造化が大変なのはシステム側ではなく、自分たちが入れたいデータの「整理されていなさ」の問題で、それは別に解決しなくても動く。
書籍を大量にPDF化してRAGに入れたい、という相談も受けました。50冊を超えるような量でも、仕組みとしては受け付けます。ただし精度は、入れた内容の質に引っ張られます。
仕組みの概要
社内PDF・Wordファイル・マニュアル
  ↓ そのままアップロード
ベクトル化(AIが文書を意味ベースで変換・格納)
  ↓
自然言語で質問入力
  ↓ 意味の近い箇所を検索
回答 + 元資料のどの部分から引いたか
「ベクトル化」は、文書をAIが検索しやすい数値の形に変換する処理です。単純なキーワード検索と違って、意味が近ければ言葉が違っても引っかかります。「退職の手続き」で聞いても「雇用終了時のフロー」が書かれた箇所がヒットする、という具合です。
ストレージはSupabaseというデータベースを使うことが多いです。クラウドで動き、無料枠もあります。
クリニックで試したこと
医療系の顧客から「チャットボットにクリニックの情報を学習させたい」と相談がありました。診療日や時間、よくある問い合わせ内容を学習させて、電話対応の負荷を下げたいという話でした。
最初にやったのは、RAGに入れる情報の整理です。「何を学習させるか」のテンプレートを一緒に作りました。診療科目、診療時間、予約の取り方、よくある質問の形式で整理する。これだけです。
ホームページに載っている情報と、院内で使っているPDFのマニュアルをそのまま入れました。整形はしていません。
導入後、実際に効果があったかどうかを顧客にヒアリングしました。「電話件数はどのくらい変わりましたか」「回答できなかった質問にはどんなものがありましたか」という質問を返しました。このフィードバックが次の精度改善の材料になります。
精度について正直に言うと
「入れれば全部答えてくれる」わけではないです。
回答精度は、入れた資料の品質と整理の度合いに比例します。顧客向けの資料では「60%台の精度を90%以上に改善できる」という目標値を提示することがありますが、初回の構築でその数字に届くかは素材次第です。
実際に試してみると、最初は「的外れな回答が出る」「何も返ってこない質問がある」という状態になります。そこから、どの資料を追加するか、どういう粒度で分割するかを調整していく。一発では決まらないのが普通です。
新人が使える状態にするまで
仕組みを作るより、「誰でも使える入口」を作るほうが実は手間がかかります。
チャットの入口をどこに置くか。社内ツールに埋め込む、専用URLを作る、どちらでも動きます。検索ボックスに質問を打ち込んで回答と出典が返ってくる画面を用意する。これが「使える状態」です。
AIにどう頼んだかというと、こんな感じです。
社内のPDFとWordファイルをまとめて取り込んで、自然言語で質問できる社内向けの検索ツールを作りたい。
- 質問を入力すると、関連する箇所と「どのファイルの何ページ目か」を返してほしい
- 社内のメンバーだけが使えるようにしたい
- 最初はファイルを10本程度入れてテストして、動きを確かめてから追加したい
「最初は少量でテスト」は大事です。全部入れてから精度がひどいと、原因の切り分けが大変になります。
動く場面と動かない場面
向いているのは次のような状況です。
- 社内にPDFやマニュアルが積み上がっていて、どこに何があるか管理できていない
- 同じ質問を新人が繰り返していて、回答者の時間を食っている
- 紙やPDFでしか管理されていない手順書がある
「ゼロから作る」ではなく「すでにある情報を引き出しやすくする」仕組みなので、学習させる元資料が存在しないと動きません。「まず資料を整える」が先です。
絶対に正確な情報だけ返してほしい用途にも、そのままでは向きません。誤答が出ても許容できるか、出典を自分で確認できる設計にするか、どちらかが必要になります。
やってみて分かったこと
整形不要で入れられる、という事実が入口のハードルを大きく下げます。ここでつまずくと思っている人が多いので、「そのまま入れてください」と伝えると話が早く進みます。
精度の改善は、使いながら続けるものです。最初に完璧を目指すより、動く状態で触り始めて、「この質問に答えられなかった」を一つずつ潰していく方が現実的でした。