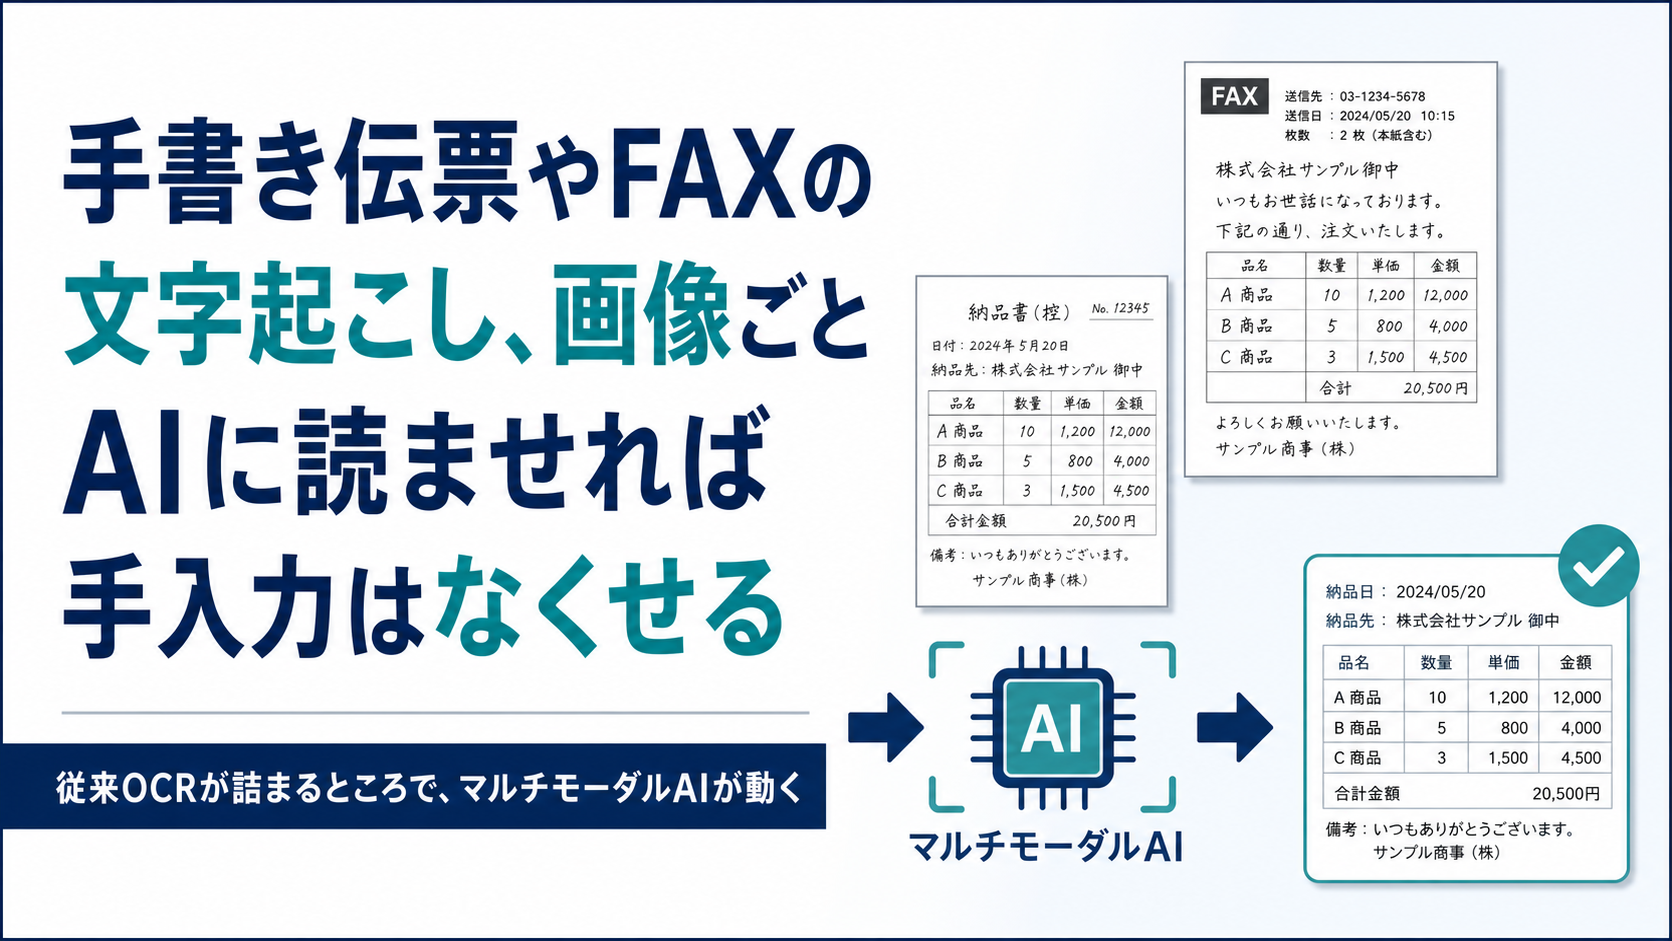
手書きの伝票やFAXの文字起こしを自動化したい、という相談を受けるとき、最初に確かめるのは「帳票のフォーマットは揃っていますか」です。
現場から上がってくる帳票を担当者が一枚ずつ目で確認して手で打ち込んでいる、その負担をなくしたい、という話はよくあります。
フォーマットが揃っているなら従来のAI-OCRで対応できます。ところが、現場から上がってくる帳票というのは「揃っていない」ことの方が多い。書き手によって字が違う。傾いて撮影されている。手書きの書き足しが混じっている。こういう状況だと、文字認識で頑張るより、画像をそのままAIに渡す方が早いです。
従来OCRが詰まる場所
従来のAI-OCRは、整形されたフォーマットに強いです。印刷された請求書や定型フォームなら精度は出ます。
問題は手書きです。文字認識ベースのOCRは、活字を前提に設計されているものが多い。手書きを読めないわけではないですが、読み誤りが出た箇所を人が後から修正する作業が残ります。件数が多いとその修正作業だけで時間がかかって、「自動化したはずなのに手間が減らない」という状態になる。
FAXも同じです。何度もコピーを重ねたFAXは印字がかすれていて、数字の「1」と「7」が混じるような誤読が出る。
画像ごと渡す、という考え方
マルチモーダルAIは、文字を一字ずつ認識する前に、画像全体を見て内容を把握します。
手書きの崩れ字や傾きは、人間が読むときに「文脈と形から判断している」わけです。マルチモーダルAIも似た読み方をするので、文字認識ベースのOCRが詰まる帳票でも動きます。
私がAIに頼む時はこんな形で渡します。
この伝票画像を読んで、以下の項目をJSON形式で返してほしい。
- 日付
- 品名
- 数量
- 単価
- 合計金額
手書きや傾きがあっても読める範囲で構造化して。読めなかった箇所は空欄にして、フラグをつけておいて。
返ってくるのはJSON形式の構造化データです。これをそのままバックエンドのシステムに流せる形にしておけば、手で打ち込む工程が消えます。
詰まりやすい点
読み誤りゼロにはなりません。画像の状態によって精度は変わります。
なので設計のポイントは2つで、「読めなかった箇所を人に見せる」「複数の読み方をして整合が取れたものだけ自動で流す」のどちらかを組み込むことです。100%自動にしようとすると、確認なしに誤ったデータが基幹に入るリスクがある。全件を人が確認する必要はなくても、怪しい箇所だけ人の目を通す仕組みは入れておくべきだと考えています。
FAX受信の場合はもう一つあります。ページが複数枚ある時、どこからどこまでが1件の注文かを判断させる必要があります。単純に1枚1件とは限らない。その分け方のルールを先に渡しておかないと、途中で詰まります。
この手が使えるかどうかの確認点
手書き帳票やFAXをAI読み取りに切り替えるとき、最初に確認するのは3点です。
- 帳票の「入口」が何か — 紙の原本をカメラで撮るのか、スキャンPDFなのか、FAX受信データか。形式によって事前処理が変わります
- 読み取り後にどこへ流すか — Excelのシートなのか基幹システムのAPIなのか、流し先が決まっていないと構造化の項目設計ができません
- 誤読の許容度 — 1件でも間違えられない(金額の送金処理など)のか、あとでまとめて照合できるのかで、確認フローの設計が変わります
これが決まれば、「AIへの頼み方」「出力するJSONの項目」「怪しい箇所の人確認フロー」を順番に組めます。逆にここが曖昧なままツールから選び始めると、後で要件が変わって最初から設計し直すことになります。
先にサンプルで試す
手書き帳票を毎月まとまった枚数手入力している現場では、担当者が触るのを「読めなかった箇所だけ」にするのが現実的な目標です。
「全部なくなる」とは言いません。どれくらい残るかは帳票の状態次第で、「月に何時間の手入力が何割になるか」は、実際のサンプル10〜20枚で試すと現実的な見通しが立ちます。先にサンプルを流してみる方が、ツール選定より早く答えが出ます。
従来OCRと使い分ける
従来のAI-OCRが向いているのは、定型フォーマットで大量に流す場合です。請求書のフォーマットが決まっていて、印刷物だけなら、専用のOCRツールを使った方がコストが低いことがあります。
マルチモーダルAIが向いているのは、手書きが混じる・フォーマットがバラバラ・FAXのかすれがある、という状況です。精度が高い分、呼び出すコストは従来より上がります。件数が少なくてフォーマットが不揃い、というケースほど費用対効果が出やすいです。
どちらが合うかは「月何枚・手書きの割合・精度の要件」の3つで大体決まります。